工作流 · 2026-10-21 核对
MOSS-Image 的 ComfyUI 工作流
Comfy-Org 官方的四个模板,放在本站方便一步导入。都需要 ComfyUI v0.42.0 或更新版本。
怎么导入
- 点「复制工作流」,在 ComfyUI 画布空白处点一下,按 Ctrl+V。
- 也可以下载 .json,直接拖进画布。
- 缺模型文件时,ComfyUI 会列出来并给出下载按钮。
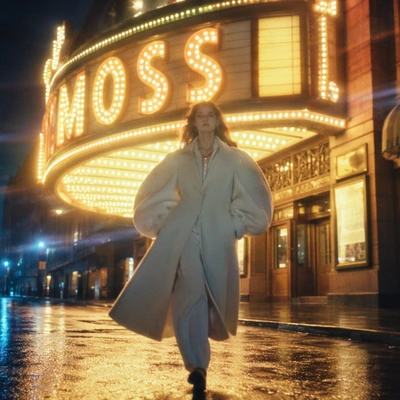
MOSS-Image: Text to Image
用 SFT 模型文生图,出图默认选这个,提示词扩写已开启。
需要的模型文件:
- moss_image_sft_int8_convrot.safetensors · 5.41 GB · ComfyUI/models/diffusion_models/
- qwen3.5_9b_w4a8_gptq.safetensors · 7.34 GB · ComfyUI/models/text_encoders/
- flux2-vae_small.safetensors · 0.25 GB · ComfyUI/models/vae/
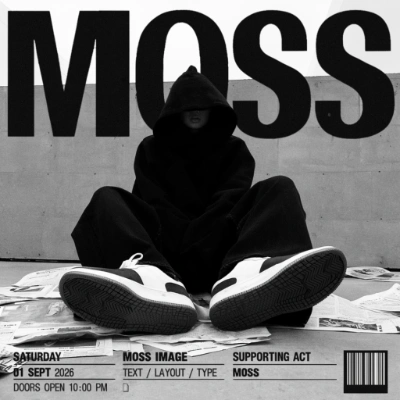
MOSS-Image Base: Text to Image
用 Base 模型文生图,Base 主要用于训练 LoRA 和继续微调。
需要的模型文件:
- moss_image_base_int8_convrot.safetensors · 5.41 GB · ComfyUI/models/diffusion_models/
- qwen3.5_9b_w4a8_gptq.safetensors · 7.34 GB · ComfyUI/models/text_encoders/
- flux2-vae_small.safetensors · 0.25 GB · ComfyUI/models/vae/
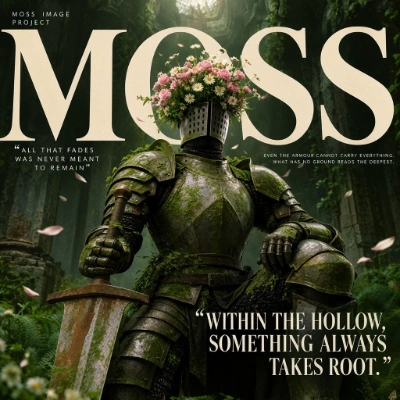
MOSS-Image: Layout-Guided Text to Image
用 SFT 模型按版面生成:画框、给每个框写描述,MOSS-Image 会把文字和物体放进框里。
需要的模型文件:
- moss_image_sft_int8_convrot.safetensors · 5.41 GB · ComfyUI/models/diffusion_models/
- qwen3.5_9b_w4a8_gptq.safetensors · 7.34 GB · ComfyUI/models/text_encoders/
- flux2-vae_small.safetensors · 0.25 GB · ComfyUI/models/vae/
本站版本已修正:官方文件加载的是 moss_image_sft_int8_convrot.safetensors,自带的下载链接却指向 Base 模型。本站版本改成了 SFT 文件的链接,其余没有改动。
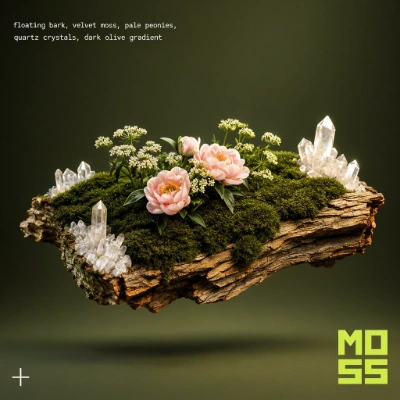
MOSS-Image Base: Layout-Guided Text to Image
用 Base 模型按版面生成。
需要的模型文件:
- moss_image_base_int8_convrot.safetensors · 5.41 GB · ComfyUI/models/diffusion_models/
- qwen3.5_9b_w4a8_gptq.safetensors · 7.34 GB · ComfyUI/models/text_encoders/
- flux2-vae_small.safetensors · 0.25 GB · ComfyUI/models/vae/
工作流和预览图版权归 Comfy Org 所有(2023 年至今),采用 MIT 许可证。 许可证与改动说明
来源: Comfy-Org/workflow_templates · ComfyUI frontend usePaste.ts · docs.comfy.org